리그 오브 레전드에서 챔피언 승률이 52%라는 문구는 간단해 보인다. 그러나 누가 어느 서버에서 어떤 역할로 플레이한 기록인지에 따라 숫자의 뜻이 달라진다. 특정 실력 구간의 관측값을 자신이 다음 경기에서 이길 확률로 옮길 수는 없다. 전적 통계의 사회적 쟁점은 숫자를 없애자는 것이 아니라, 숫자가 만들어진 조건을 이용자에게 얼마나 설명하는가에 있다.
분모에 누가 들어갔는지가 먼저다
한 경기에 양 팀 10명의 기록이 있다면 경기 한 건과 선수별 경기 기록 10건은 다른 단위다. 승리한 다섯 명과 패배한 다섯 명을 모두 세면 승패는 균형을 이룬다. 하지만 특정 등급 이상인 선수만 골라 담으면 그 부분집합이 반드시 50%가 되는 것은 아니다. 서로 다른 등급의 선수가 만난 경기에서 어떤 기록을 포함했는지부터 알아야 한다.
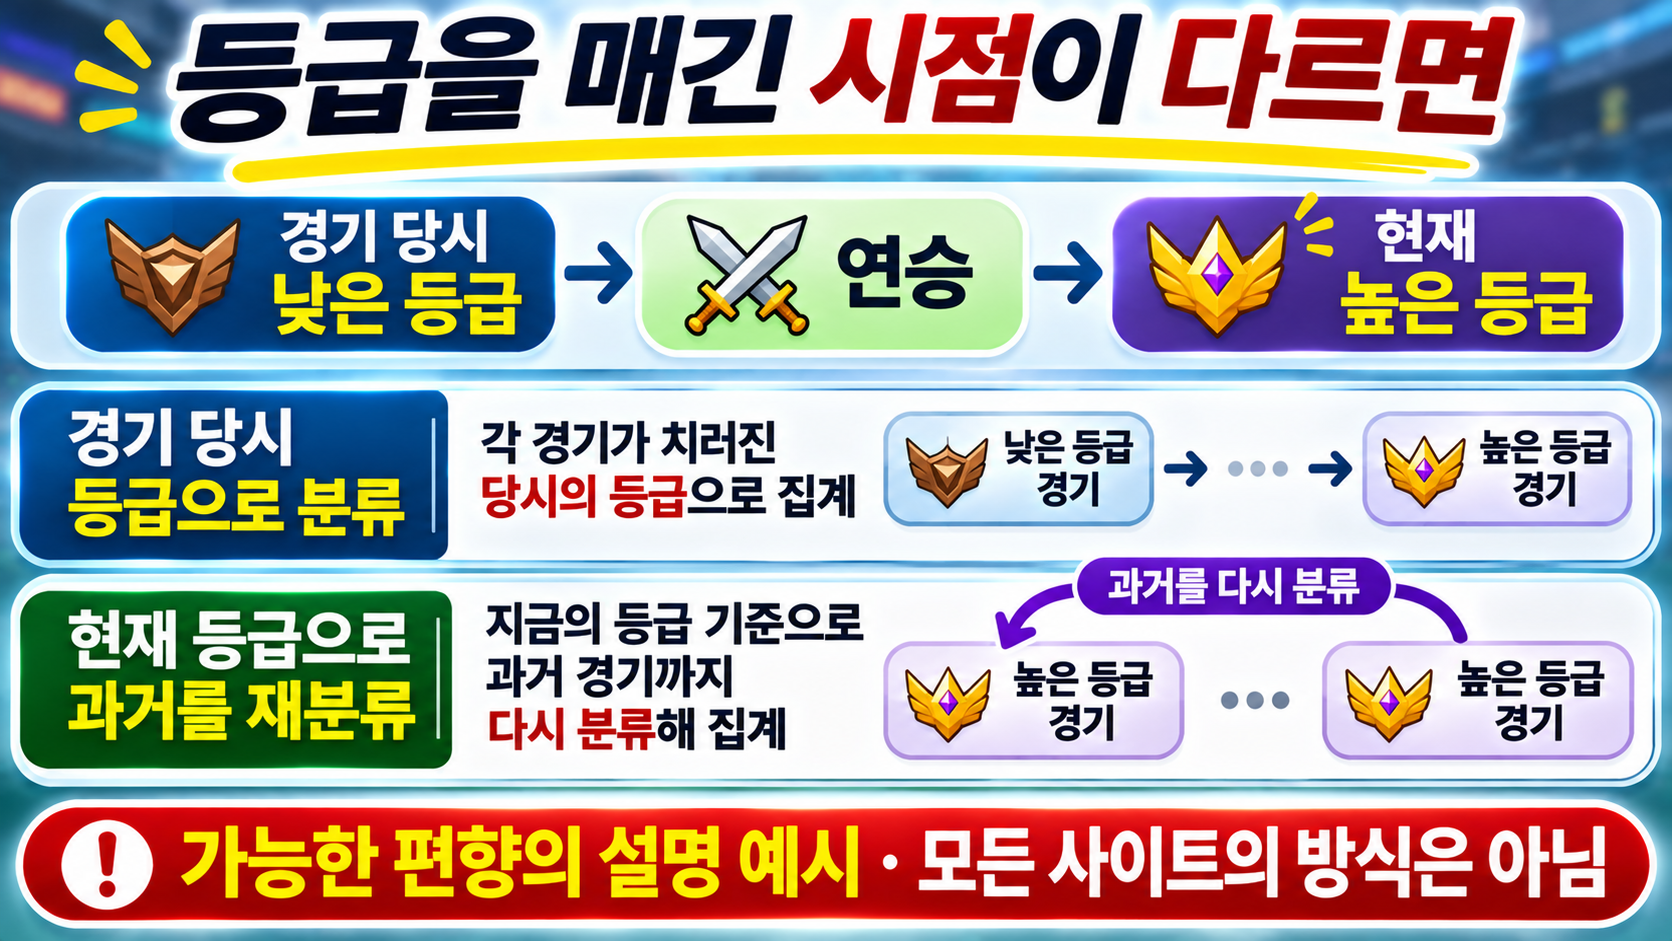
분류 시점도 중요하다. 경기할 때는 낮은 등급이었던 선수가 연승 뒤 승급했다고 가정하자. 이전 승리 기록을 오늘의 등급으로 다시 분류하면 높은 등급의 표에 승리가 더 들어갈 수 있다. 반대로 강등한 사람의 패배 기록은 빠질 수 있다. 이는 가능한 편향의 구조를 설명한 예시이며 모든 전적 서비스가 같은 방식으로 운영된다는 확인은 아니다.
커뮤니티의 원 분석 작성자는 패치 16.17의 특정 집계를 놓고 이 문제를 제기했다. 작성자가 편향을 재현하려고 에메랄드 이상 집단을 현재 등급 기준으로 직전 3일에 소급 분류한 시험에서, 선수별 경기 기록 208,884건의 승률은 51.59%였다. 비교한 사이트 수치는 51.78%로 제시됐다. 이는 해당 작성자의 분석 결과이지 본지가 서버 자료를 독립 재현한 결과나 현재 패치 전체의 공식 승률이 아니다. 표본 단위도 ‘서로 다른 경기 20만 판’이라고 바꾸어 쓰면 안 된다. 분석 작성자의 원 게시물
이 문제 제기는 조사할 가치가 있지만 곧바로 모든 사이트의 조작을 입증하지 않는다. 서비스별 수집 범위와 갱신 방식, 게임 시점의 등급 보존 여부를 확인해야 하기 때문이다. 원 분석에서 제시한 특정 비율을 다른 시즌·서버·등급에 그대로 적용하는 것도 적절하지 않다.
경기 당시 등급과 현재 등급의 차이가 분류에 미치는 영향의 가상 예시. 모든 사이트가 이 방식이라는 뜻은 아니다. 지정 GPTs로 제작한 인공지능 설명 이미지이며 실제 현장 사진이 아닙니다.
기다린다고 모든 오차가 없어지지는 않는다
패치 직후에는 아직 기록이 적어 몇 번의 승패가 비율을 크게 바꿀 수 있다. 시간이 지나 표본이 늘면 이 흔들림을 줄이는 데 도움이 된다. 그러나 표본 수 부족과 분류 방식의 편향은 별개다. 과거 경기를 현재 등급으로 계속 다시 분류하는 구조라면 사흘이 지났다는 이유로 문제가 해결되지는 않는다.
같은 이유로 전적을 비교할 때는 단순히 소수점 자리 수가 많은 표를 고르는 것으로 충분하지 않다. 다음 조건을 함께 확인해야 비교의 의미가 생긴다.
확인 항목
달라지면 생기는 문제
패치와 관측 기간
서로 다른 밸런스와 수집 기간을 비교할 수 있음
서버·등급·역할
실력과 플레이 환경이 다른 집단을 섞을 수 있음
경기 수와 집계 단위
적은 표본의 급등이나 중복 집계를 놓칠 수 있음
등급을 매긴 시점
경기 이후 승급·강등이 과거 분류에 영향을 줄 수 있음
원 승률과 보정 점수
실제 관측 비율과 모델 평가를 같은 값으로 읽을 수 있음
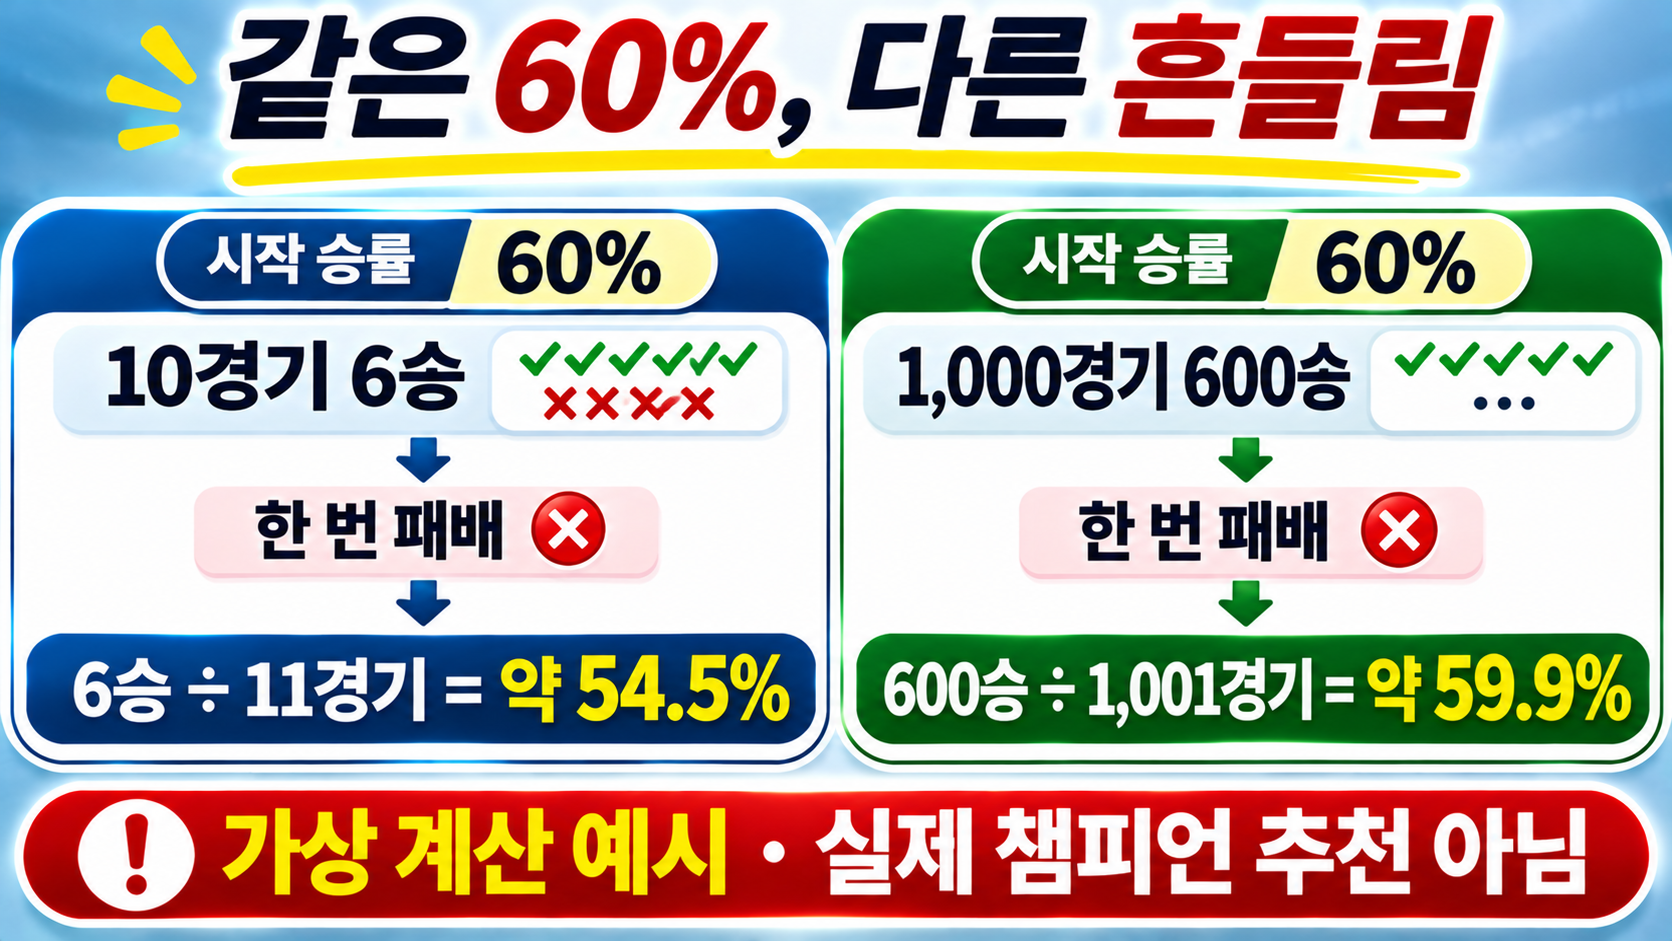
예를 들어 가상의 표에서 10번 중 6번 이긴 챔피언과 1,000번 중 600번 이긴 챔피언은 모두 승률 60%다. 전자에서 다음 한 경기를 지면 6승 5패, 약 54.5%로 내려간다. 후자는 600승 401패, 약 59.9%다. 비율이 같다고 추가 한 경기의 영향까지 같은 것은 아니다. 이 계산은 실제 챔피언 추천이나 미래 승률 예측이 아니다.
한 번의 패배가 작은 표본과 큰 표본에 미치는 차이를 계산한 가상 예시. 지정 GPTs로 제작한 인공지능 설명 이미지이며 실제 현장 사진이 아닙니다.
보정값은 설명이 필요한 편집 선택이다
작은 표본의 극단적인 값을 완화하려는 방법도 있다. 독립 서비스 LegendsTracker는 기준 승률과 관측 승률을 섞는 보정, 불확실성을 고려하는 하한값을 방법론에 공개한다. 이 서비스도 자신이 확보한 표본이 작고 주로 유럽 서부 서버에 기반해 변동성이 크다고 설명한다. 방법을 공개했다는 점과 다른 서비스보다 정확하다는 독립 검증은 구분해야 한다. 서비스 자체 방법론
이용자가 확인할 것은 복잡한 수식을 외우는 일이 아니다. 화면의 순위가 승률순인지, 표본이 적으면 낮춰 평가하는 방식인지, 역할과 경기 시간을 반영하는지 알 수 있어야 한다. 같은 경기를 놓고도 서비스의 가중치가 다르면 평가가 달라질 수 있다. 평점이 게임사가 판정한 공식 실력 등급이라고 생각해서도 안 된다.
선수에게 통계는 복기의 출발점이 될 수 있다. 다만 낮은 점수를 고의적인 패배나 태만의 증거로 단정하려면 통계가 담지 못한 맥락을 건너뛰게 된다. 실제 판단을 검토하려면 당시 시야, 양 팀 위치, 목표물과 팀의 선택을 리플레이에서 함께 살펴야 한다. 숫자 하나로 다른 플레이어의 의도까지 입증할 수는 없다.
편리한 보조 기능과 허용된 기능은 다르다
라이엇의 일반 개발자 정책은 공식 실력 순위를 대체하는 점수 계산기, 숨겨진 플레이어의 신원 공개, 부당한 경쟁 우위를 제한한다. 제품 등록·검토와 수익화 조건도 따로 규정한다. 앱이 유료라는 이유만으로 승인이나 정확성이 보장되는 것은 아니다. 라이엇 일반 개발자 정책
오버울프의 라이엇 준수 안내에는 상대 능력·소환사 주문의 재사용 시간을 추적하는 기능과 상대 레벨 변화에 따른 특정 행동 지시 등 구체적인 제한이 나온다. 이는 통계를 본 사람이 자신의 판단으로 전략을 고민하는 것과 앱이 경기 중 행동을 대신 정해 주는 것을 구분하는 문제다. 다른 게임 모드의 규정을 롤 전체에 그대로 옮겨 설명해서도 안 된다. 오버울프의 라이엇 게임 준수 안내
설치 전에는 개발사와 공식 배포 경로, 현재 제공하는 기능, 계정 연동 범위와 해제 방법을 확인할 수 있다. 안내가 불분명하면 기능의 허용 여부를 추측해 쓰기보다 서비스에 문의하는 편이 낫다. 로그인 암호나 인증 코드를 낯선 지원 창에 전달할 이유는 없다.
이용자에게 필요한 공개 정보
전적 서비스가 제공할 설명은 적어도 세 층으로 나눌 수 있다. 어떤 경기와 선수를 모았는지, 그 기록을 어떤 계산으로 점수로 바꿨는지, 계산할 수 없는 정보는 무엇인지다. 개인정보의 수집·보관·삭제 안내는 이와 별도로 확인해야 한다. 특정 평점에 동의하지 않는다는 사정만으로 법적 정정이나 삭제 요구가 모두 인정된다고 단정할 수는 없다.
독자가 비교 화면을 저장할 때도 사이트 주소와 조회 시각, 필터, 표본 수를 함께 남기면 도움이 된다. 나중에 숫자가 달라져도 실제 경기 기록이 늘어난 것인지, 필터가 바뀐 것인지, 계산법이 갱신된 것인지 구분할 단서가 된다. 다른 사람에게 화면을 공유할 때는 계정 이름 등 불필요한 식별 정보를 가리는 편이 좋다.
승률은 선택에 도움을 주는 관측 자료다. 자신의 숙련도와 팀 구성, 상대 조합까지 지워 버리는 정답표는 아니다. 전적 서비스의 신뢰를 판단할 기준도 높은 숫자나 화려한 등급보다 계산 조건과 한계를 확인할 수 있는가에 두어야 한다.
자료 확인: 2026년 11월 20일. 커뮤니티 분석과 서비스 자체 설명은 출처의 주장으로 구분했으며 본지의 서버 데이터 독립 실험으로 표현하지 않았다.
A 52% LoL win rate is not your win probability: why match statistics need an explanation
Win rates are conditional observations, not predictions for an individual game. AI editorial illustration created with the designated GPT; not a photograph of an actual event.
Sample size is only part of the story. Who enters a dataset, and when their rank is assigned, also matter. Statistical uncertainty and the rules for companion apps are separate questions.
A champion's 52% win rate in League of Legends looks straightforward. Its meaning changes, however, with the server, rank and role represented. An observed result for one group does not become the probability that you will win your next game. The public-interest question is not whether statistics should disappear, but whether services adequately explain how their numbers were made.
Start with the denominator
One match with ten participants is one match but ten player-game records. Counting all five winners and five losers balances wins and losses. Selecting only players above a rank threshold does not necessarily leave a 50% win rate. In mixed-rank matches, the first question is which participants were included.
The timing of classification matters too. Imagine someone wins several games at a lower rank and then moves up. Reclassifying their earlier wins using today's rank can add wins to the higher-rank group. Losses by someone subsequently demoted can leave it. This illustrates a possible source of bias; it does not establish that every statistics service uses that method.
The author of a community analysis raised this issue using a particular patch 16.17 dataset. In a test intended to reproduce the bias, the author retrospectively classified the preceding three days' records for the Emerald-and-above population using current rank. The resulting 208,884 player-game records had a reported win rate of 51.59%, against a cited site figure of 51.78%. These are the author's results, not a server-data experiment independently reproduced by this newsroom or the official rate for today's patch. Nor should the unit be rewritten as more than 200,000 distinct matches. Original analysis
The argument merits examination but does not establish manipulation by every service. Collection coverage, update procedures and whether historical rank is preserved require service-specific verification. A ratio from that analysis should not be transferred unchanged to another season, server or rank.
A hypothetical illustration of rank-timing classification bias, not a claim about every site. AI editorial illustration created with the designated GPT; not a photograph of an actual event.
Waiting does not remove every kind of error
Early in a patch, a few results can move a small sample sharply. More observations can help reduce this fluctuation. But insufficient sample size and classification bias are different problems. If old matches continue to be reassigned using current rank, waiting three days does not automatically fix the process.
For the same reason, selecting the table with the most decimal places is not enough. Comparisons need matching conditions.
Check
What can go wrong when it differs
Patch and observation window
Different game balance or collection periods are compared
Server, rank and role
Groups with different skills and playing conditions are combined
Sample size and counting unit
Small-sample spikes or duplicate counting can be missed
Time of rank assignment
Later promotion or demotion can affect historical classification
Raw rate versus adjusted score
An observed proportion is mistaken for a model's assessment
Consider a hypothetical champion with six wins in ten games and another with 600 wins in 1,000. Both have a 60% win rate. One additional loss takes the first to six wins and five losses, or about 54.5%. It takes the second to 600 wins and 401 losses, or about 59.9%. Identical percentages do not mean identical sensitivity to one more result. This arithmetic is not a real champion recommendation or a forecast.
A hypothetical calculation shows how one loss affects small and large samples. AI editorial illustration created with the designated GPT; not a photograph of an actual event.
Adjustments are choices that need explaining
Methods exist to moderate extreme small-sample results. Independent service LegendsTracker describes blending an observed rate with a reference rate and using a lower bound that accounts for uncertainty. It also acknowledges that its smaller, mainly EU West sample makes its rates more volatile. Publishing a method is different from independent proof that a service is more accurate than its competitors. The service's methodology
Users do not need to memorize complex formulas. They should be able to tell whether rankings follow raw win rate, penalize small samples or account for role and game duration. Different weights can produce different assessments of the same match. A service's grade should not be mistaken for the game's official skill rank.
Statistics can begin a review of one's play. Treating a low score as proof of deliberate losing or laziness skips context the score may not capture. Examining an actual decision means looking at vision, player positions, objectives and team choices in the replay. One number cannot establish another player's intent.
Convenient features are not necessarily permitted features
Riot's general developer policy restricts alternatives to official skill rankings, exposing deliberately hidden players and unfair competitive advantages. Product review and monetization have separate conditions. A paid app is not, by that fact alone, approved or accurate. Riot's general developer policy
Overwolf's Riot compliance guidance gives more specific restrictions, including tracking enemy ability or summoner-spell cooldowns and directing actions based on enemy level changes. The distinction is between a player considering statistics and an app making in-game decisions for them. Rules for a different game mode should not be applied indiscriminately to all of LoL. Overwolf's Riot compliance guidance
Before installing, users can check the developer, official distribution channel, current features, account-linking scope and how to disconnect. If the explanation is unclear, asking the service is preferable to assuming a feature is allowed. There is no reason to send a login password or verification code through an unfamiliar support window.
What services should explain
Useful disclosure has at least three layers: which players and matches were collected, how those records became a score, and what the calculation cannot observe. Collection, retention and deletion of personal information require a separate privacy review. Disagreeing with a grade alone does not establish that every legal correction or deletion request must be granted.
When saving a comparison, keeping the site address, retrieval time, filters and sample size helps. If the number later changes, those details can help distinguish additional matches, a changed filter and a revised calculation. Unnecessary identifiers such as account names should be obscured before sharing screenshots.
A win rate is observed information that can support a choice. It is not an answer key that replaces individual proficiency, team composition and opponents. A service's reliability should be judged by whether its calculation and limitations are intelligible, rather than by attractive numbers or striking grades.
Sources checked November 20, 2026. Community analysis and service descriptions are attributed claims, not independently reproduced newsroom experiments using server data.
PRO SOURCING ENGINE만인의 탑 빅데이터 솔루션
★ 가입 시 600 크레딧(120회) 전원 무료
내가 찾는 상품 키워드, 지금 얼마나 검색될까?
네이버 월간 검색량 + 구글 볼륨 + 아이템스카우트 실시간 상품수와 경쟁강도 배지를 0.5초 만에 무료로 확인하세요.
MANINTOP NEWSLETTER
📬 만인의 탑 뉴스레터 무료 구독
오늘 보신 정책·시사 뉴스가 유익하셨나요? 매일 엄선되는 알짜 복지 혜택과 국회 실시간 속보를 이메일로 가장 먼저 받아보세요. (평생 무료)
1월이 시작되면 감기는 이미 우리 곁에 와 있습니다. 2월, 3월, 4월까지 이어지는 추위와 건조함은 코와 목을 가장 먼저 공격합니다. 아침에 일어나자마자 막혀 있는 코. 계속 흐르는 콧물. 괜히 칼칼해지는 목. 이 증상은 “시작”일 뿐입니다. 한 번 무너지면 일주일, 길면 한 달까지 끌고 갑니다. 약을 먹으면 잠깐 괜찮아집니다. 하지만 며칠 뒤 또 반복됩니다. 왜일까요? 감기는 ‘치료’의 문제가 아니라 ‘관리’의 문제이기 때문입니다. 대부분은 감기가 오고 나서 약을 찾습니다. 하지만 진짜 중요한 건 감기가 오기 전에 코와 목을 지키는 것입니다. 건조한 실내 공기, 차가운 바깥 공기, 눈에 보이지 않는 세균. 코와 목은 매일 공격받고 있습니다. 지긋지긋하죠! 그런데도 우리는 아무 준비 없이 버티고 있습니다. 이번 겨울도 그렇게 보낼 건가요? 사실 방법은 어렵지 않습니다. 코를 깨끗하게 관리하고, 목을 따뜻하게 보호하고, 점막을 촉촉하게 유지하고, 기관지를 미리 관리하고, 외부 공기를 차단하는 것. 이 다섯 가지만 꾸준히 해도 감기약 없이 겨울을 보내는 것이 충분히 가능합니다. 🔥 이제부터 그 방법을 하나씩 살펴보겠습니다. 🔥 1. 코와 목을 먼저 관리해야 하는 과학적 이유 감기의 대부분은 코 점막에서 시작됩니다. 국제 학술지 Nature Reviews Microbiology 와 Journal of Allergy and Clinical Immunology 에 실린 호흡기 감염 관련 연구들에서는, 감기 바이러스가 비강 상피세포에 먼저 부착해 증식한다는 점을 설명하고 ...
리모델링사업이 진행 중인 아파트를 매매할 때 “계약금 10%를 언제까지 내야 하느냐”는 질문이 특히 많이 나옵니다. 이주공고(이주 안내)가 7~11월쯤이라고 들으면, 그 시점에 맞춰 계약금도 움직일 것 같아서 더 헷갈리기 쉽습니다. 하지만 실제 납부기한은 ‘이주공고가 언제냐’만으로 자동 결정되지 않는 경우가 많습니다. 1) 계약금 10% 납부기한: 결국 ‘문서에 적힌 일정’이 기준 계약금 10%를 언제까지 납부해야 하는지는, 내가 서명하는 매매계약서(특약 포함) 와 사업주체/조합이 제시한 공고·안내문 에 적힌 납부 일정이 기준이 됩니다. 실제 공고문에서는 분양대금 납부의 큰 틀(계약금→중도금→잔금)을 먼저 안내하고, 상세 일정은 별도 표나 유의사항으로 제시하는 방식이 흔합니다. 또, 계약서 문구에 따라 지급 시점이 조건부로 설정될 수도 있습니다. 예를 들어 한 사례 소개 자료에서는 용역계약서에 잔금(10%) 지급시기가 “사업승인 후”로 기재되어 있었다는 점이 언급됩니다. 이런 식으로 ‘사업 단계’와 지급을 연동하는 문구가 들어가면, 질문의 답은 계약서 문구를 확인해야만 확정됩니다. 관련 내용은 링크 에서 문구 사례를 확인할 수 있습니다. 2) 입주자모집공고에서 확인되는 ‘납부 순서’와 잔금 마감 시점 공고문에 적힌 문구를 보면, 납부 순서와 잔금 마감에 대한 기준이 비교적 명확하게 제시되는 경우가 있습니다. 예를 들어 한 입주자모집공고에는 “분양금액(주택가격)은 계약금, 중도금, 잔금의 순서로 납부”하며 “잔금은 입주(열쇠 수령일) 전에 완납”해야 한다고 안내되어 있습니다. (문구 확인: 링크 ) 이 문구가 의미하는 바는 최소 2가지입니다. 분양/공급 형태의 문서에서는 ‘계약금→중도금→잔금’ 흐름이 공식적으로 안내될 수 있습니다. 잔금은 “입주(열쇠 수령)” 이전에 완납해야 한다는 마감 기준이 문서에 적혀 있을 수 있습니다. 다만, 위 공고문 문구는 잔금 마감에 대한 기준을 보여주지만, 계약금 10%의...
윤석열 전 대통령 탄핵 인용 소식을 접하면, 가장 궁금한 지점은 ‘헌재가 정확히 무엇을 위헌·위법으로 봤는가’입니다. 또한 탄핵과 별개로 진행되는 형사재판(내란 우두머리 혐의 등)이 어디까지 왔는지도 함께 정리할 필요가 있습니다. 아래 내용은 제공된 기사/게시물 스니펫과 링크에서 확인되는 범위만 모아, 일반인이 흐름을 이해하기 쉽게 정리한 것입니다. 1) 탄핵 인용 관련: 스니펫에서 확인되는 ‘판단의 골격’ 제공된 근거 중 조국혁신당 사이트에는 헌법재판소가 윤석열 탄핵 심판에서 “피청구인의 위헌·위법행위는 국민 신임 …”이라는 취지로 판단했다는 문장이 인용돼 있습니다( 링크 ). 이 인용문만 놓고 보면, ‘위헌·위법행위’가 있었는지와 그로 인해 ‘국민의 신임’이 어떻게 평가됐는지가 핵심 축으로 소개됩니다. 다만 질문에서 요청하신 세부 항목, 즉 비상계엄 선포 자체를 문제 삼은 구체적 이유, 계엄 이후 조치(포고령, 국회 통제 등)의 어떤 지점이 헌법 위반인지, 국회의 권한행사 방해 및 정치활동 제약을 어떤 논리로 판단했는지 등은, 이번에 제공된 근거의 제목/스니펫만으로는 조항·사실관계·판단 구조가 그대로 제시돼 있지 않습니다. 따라서 이 글에서는 ‘헌재가 무엇을 문제 삼았다’는 세부 리스트를 단정적으로 재구성하기보다, 현재 확인 가능한 문구 수준의 요약(위헌·위법행위 → 국민 신임의 문제로 평가)까지만 적습니다. 만약 헌재 결정문 전문(주문 및 이유)이 추가로 확인되면, 그때는 문장 단위로 ‘어떤 행위’와 ‘어떤 헌법 원리/조항’이 연결되는지(예: 권력분립, 국회의 권한, 정치적 기본권 등) 구조화해 정리하는 것이 가장 정확합니다. 2) 형사 절차(내란 혐의) 관련: 체포영장과 1심 선고 언급 탄핵 심판과 별도로, 12·3 비상계엄 사태로 내란 혐의를 받는 윤석열 대통령에 대해 2024년 12월 31일 체포 영장이 발부됐다는 BBC 보도가 있습니다( 링크 ). 해당 보도는 ‘현직 대통령’에 대한 체포영장 발부라는 점을 함께 언급합니다. 또...